Why Inspection Teams Confuse Numeric Ratings with True Measurements
Quality assurance programs regularly record numerical scores for subjective appearance parameters, generating an illusion of empirical precision where only qualitative ranking exists.
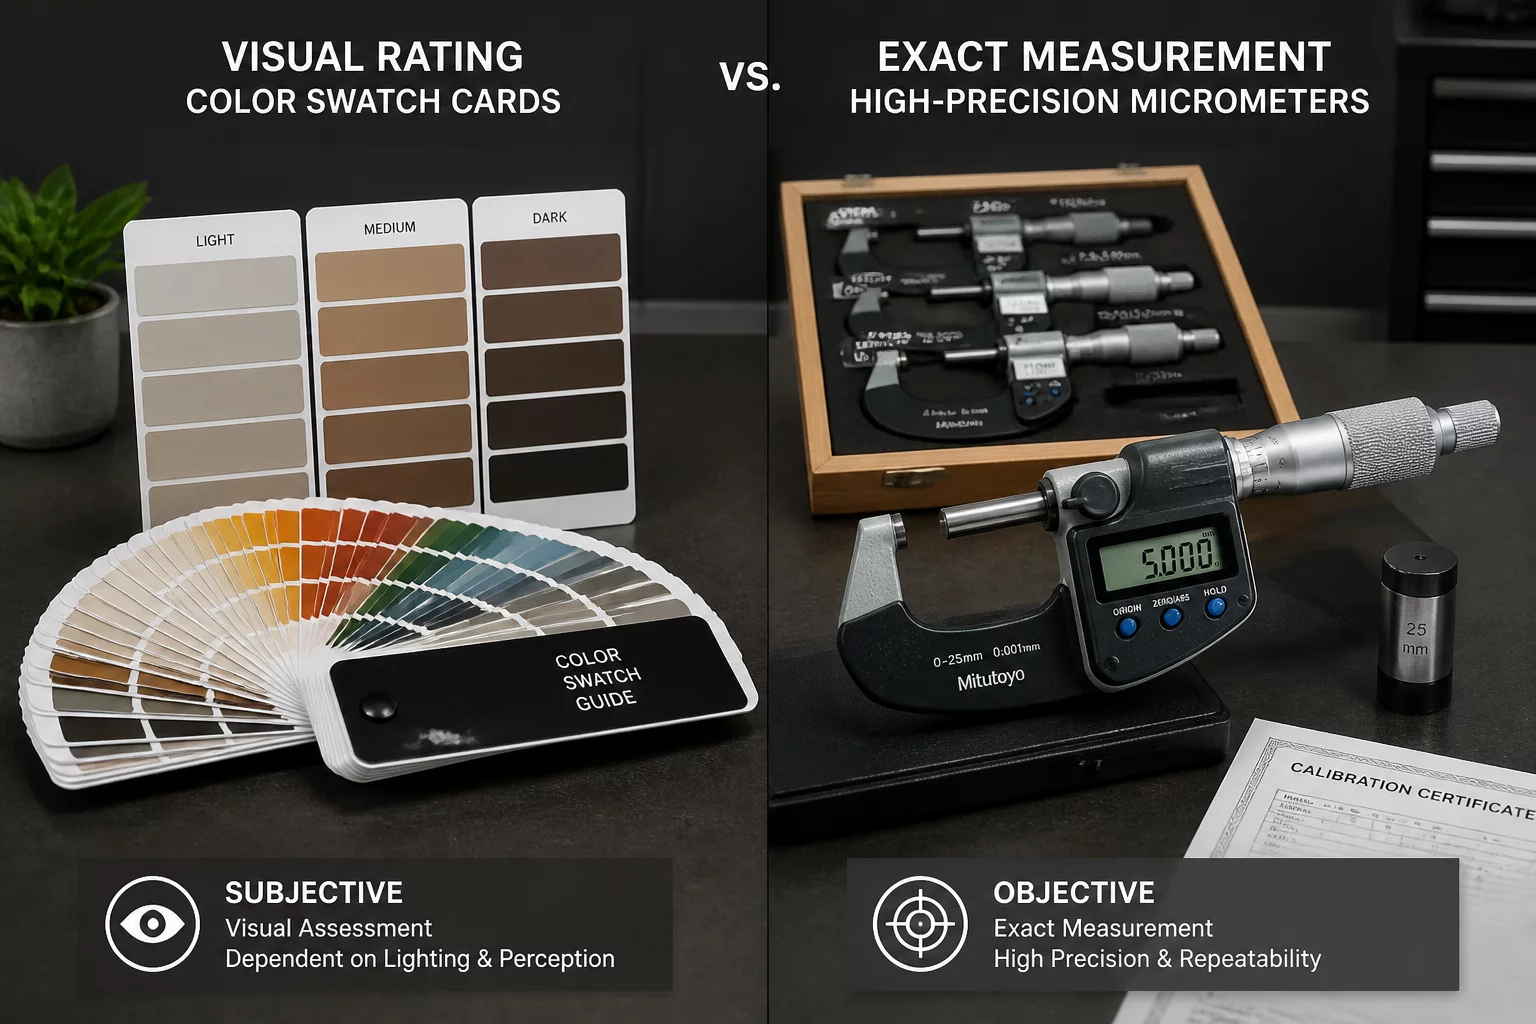
In high-speed production environments, assigning a score such as "Grade 4 Surface Texture" or recording a 1-to-5 aesthetic severity value appears indistinguishable from logging a digital dial indicator measurement. Mathematically and operationally, however, these two tasks belong to fundamentally incompatible data classifications. A true physical measurement exists along an interval or ratio scale characterized by equal increments and a well-defined physical zero point. Four millimeters reflects precisely twice the linear displacement of two millimeters. By contrast, a visual rating operates along an ordinal scale where numeric distances between ranks are arbitrary and non-linear.
When quality analysts compute mathematical means, standard deviations, or capability metrics like Cpk from visual ranking tallies, they generate distorted process representations. The recorded digits document comparative human sentiment rather than continuous physical properties. Treating ordinal scores as interval metrics conceals the psychological heuristics that examiners employ on factory floors. A technician evaluates visual artifacts relative to the cleanliness of the preceding twenty pieces, introducing baseline slippage that physical micrometers never demonstrate when properly calibrated.
Assigning an Arabic numeral to an aesthetic impression does not convert a subjective appraisal into an objective measurement. It merely codifies human visual judgment into deceptive numerical shorthand.
— Emily Taylor, Lead Metrology & Quality Systems Specialist
Establishing Strict Demarcations Between Gauge Metrology and Sensory Grading
Harmonizing quality standards across independent inspection shifts requires cleanly segregating physical dimensional verification from sensory appraisal workflows. Attempting to convert every aesthetic feature into an instrumented measurement creates severe line bottlenecks, while allowing uncontrolled numerical ratings yields widespread disagreement between senior auditors. Engineering teams must erect clear procedural boundaries separating objective metrology from controlled comparative grading.
- Physical Instrument Primacy: Deploy direct dimensional tools, optical profilometers, or spectrophotometers wherever an engineering tolerance is quantitatively defined, eliminating manual scoring entirely for geometric parameters.
- Physical Boundary Coupons: Replace abstract numeric rating scales with master physical limit plaques, converting internal memory retrieval into simultaneous side-by-side matching under controlled D65 lighting booths.
- Independent Statistical Evaluation: Audit continuous measurement loops using conventional Gage R&R studies, while evaluating visual grading reliability strictly through attribute agreement analysis, Cohen's kappa, and Kendall's concordance coefficients.
By maintaining distinct operational pipelines for instrumented measurements and visual assessments, quality management preserves the statistical integrity of manufacturing audits. Inspectors stop forcing non-parametric visual rankings into Gaussian bell curves, while visual evaluators gain explicit physical boundary standards that eliminate arbitrary variance across operating shifts.